識模仿學習猶如人腦
【本報訊】 AlphaGo能夠擊敗圍棋高手,原因是採用深度學習的技術,這技術包含兩種神經網絡,令AI可以透過模仿下棋方法,從中學習如何在困局中突圍,猶如人腦一般。
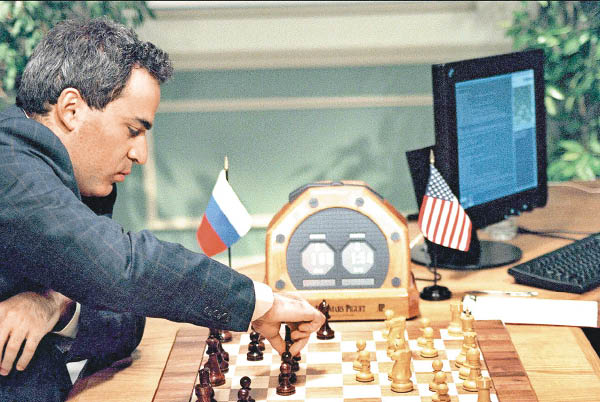
卡斯帕羅夫(資料圖片)
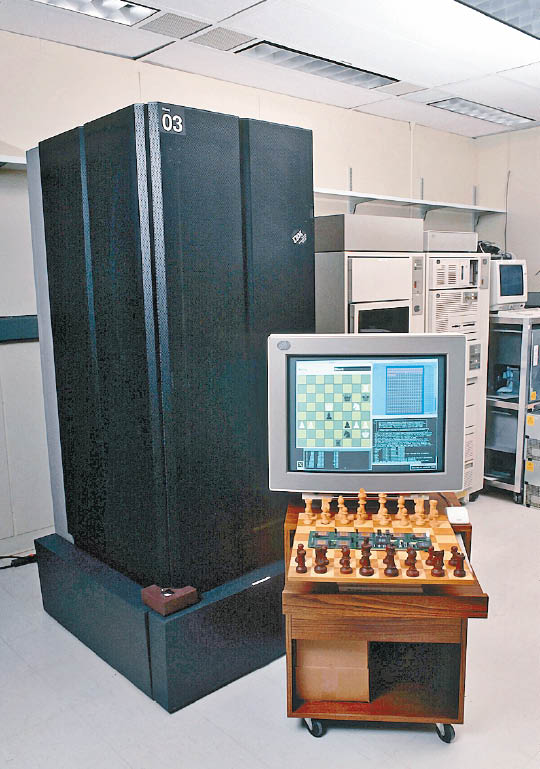
「深藍」(資料圖片)
朱克伯格去年着手研發
AlphaGo的技術策略網絡(Policy network)及值網絡(Value network)。前者負責將棋步的可能性縮小,而後者幫助AlphaGo學習評估棋局形勢;結合兩者之能,AlphaGo便能選出最佳棋步。
為極速訓練AI,研究員讓它們學習數以百萬計的棋局,預計每一步棋的可能性,之後再讓AI與自己對弈,從中磨練技術。而AI最大的優勝之處,便是不會犯錯,而且一天可以玩百萬局棋,並學習所有的棋法。連facebook創辦人朱克伯格也表示,他已於去年着手研發圍棋AI。